
Claude Fable 5.2 w skrócie
- Premiera: 9 listopada 2026 roku, w aplikacjach Claude, w Claude Code i w API pod nazwą
claude-fable-5-2(Anthropic). - Cena: 8 dolarów za milion tokenów wysłanych do modelu i 40 dolarów za milion tokenów odpowiedzi. Fable 5.1 kosztował 10 i 50 dolarów.
- Ranking: 65 punktów i 1. miejsce na 74 modele w Artificial Analysis Intelligence Index.
- Koszt zadania: na najwyższym poziomie wysiłku 26,54 dolara, na poziomie high 9,08 dolara (Artificial Analysis).
- Rada producenta: Anthropic poleca na co dzień zaczynać od Claude Opus 5.5, a Fable zostawić do najtrudniejszych zadań.
Claude Fable 5.2 to najmocniejszy publicznie dostępny model językowy firmy Anthropic, czyli program, który czyta i pisze tekst oraz kod. Ma bliźniaka, Mythos 5.2, z częścią zabezpieczeń zdjętych na potrzeby cyberbezpieczeństwa i nauk o życiu. Mythos trafia tylko do sprawdzonych organizacji, więc w tym tekście zajmujemy się wyłącznie Fable.
Co zmieniło się w Fable 5.2 względem wersji 5.1?
Anthropic wymienia w ogłoszeniu cztery zmiany, które odczuje zwykły użytkownik.
Szybkość. Według Anthropic odpowiedzi są do 30% szybsze niż w Fable 5.1. Do tego dochodzi nowy tryb szybki, który przyspiesza pisanie odpowiedzi do 2,5 raza, ale kosztuje dwa razy więcej: 16 i 80 dolarów za milion tokenów.
Cena. Według cennika Anthropic stawki spadły o jedną piątą, z 10 do 8 dolarów za milion tokenów wejścia i z 50 do 40 dolarów za milion tokenów odpowiedzi.
Mniej odmów. Według Anthropic model o około 55% rzadziej odmawia wykonania zadania bez potrzeby. W pytaniach z cyberbezpieczeństwa to około 60%, a w biologii około 40%. Dane pochodzą z wczesnych testów w claude.ai, Claude Code i Cowork.
Praca zdalna. W tabeli Anthropic w Remote Labor Index, czyli teście prawdziwych zleceń wykonywanych zdalnie, wynik wzrósł z 17,9% do 41,3%. W tej samej tabeli Opus 5.5 ma 21,3%, a GPT-6 Astra 20,8%. To największy skok w całej tabeli Anthropic.
Według dokumentacji Anthropic bez zmian zostało okno kontekstu, czyli ilość tekstu, którą model ogarnia naraz: milion tokenów. Odpowiedź może mieć do 128 tysięcy tokenów.
Ile kosztuje Claude Fable 5.2 w porównaniu z Opus 5.5 i GPT-6 Astra?
Tokeny to kawałki tekstu, za które płaci się w AI. Firmy podają ceny za milion tokenów osobno dla tekstu wysłanego do modelu i dla jego odpowiedzi.
| Model | Tekst wysłany (1 mln tokenów) | Odpowiedź (1 mln tokenów) | Źródło |
|---|---|---|---|
| GPT-6 Astra | 10 USD | 50 USD | OpenAI |
| Claude Fable 5.2 | 8 USD | 40 USD | Anthropic |
| Claude Opus 5.5 | 4 USD | 20 USD | Anthropic |
| Claude Sonnet 5.5 | 2 USD | 10 USD | Anthropic |
| Claude Haiku 5.5 | 0,10 USD | 0,50 USD | Anthropic |
Według cennika OpenAI GPT-6 Astra kosztuje 10 i 50 dolarów, więc Fable 5.2 jest od niego o 20% tańszy za każdy token. Od Opus 5.5 jest dwa razy droższy, od Sonnet 5.5 cztery razy, a od Haiku 5.5 osiemdziesiąt razy przy tekście wysłanym do modelu. Cena Haiku dotyczy zapytań do 100 tysięcy tokenów. U Astry powyżej 272 tysięcy tokenów stawka rośnie do 20 i 75 dolarów.
W sieci pojawia się też nazwa „Astra 6.1”. Takiego modelu nie ma ani w cenniku OpenAI, ani w rankingu Artificial Analysis. Najmocniejszy model OpenAI to GPT-6 Astra z 3 września, a w serii 6.1 są tańsze GPT-6.1 Sol i GPT-6.1 Terra.
Jak Fable 5.2 wypada w rankingu Artificial Analysis?
Artificial Analysis to niezależna firma, która sama uruchamia modele na tym samym zestawie dziewięciu testów i liczy z nich jedną ocenę. W wersji 5 indeksu Fable 5.2 na najwyższym poziomie wysiłku ma 65 punktów i zajmuje 1. miejsce na 74 modele.
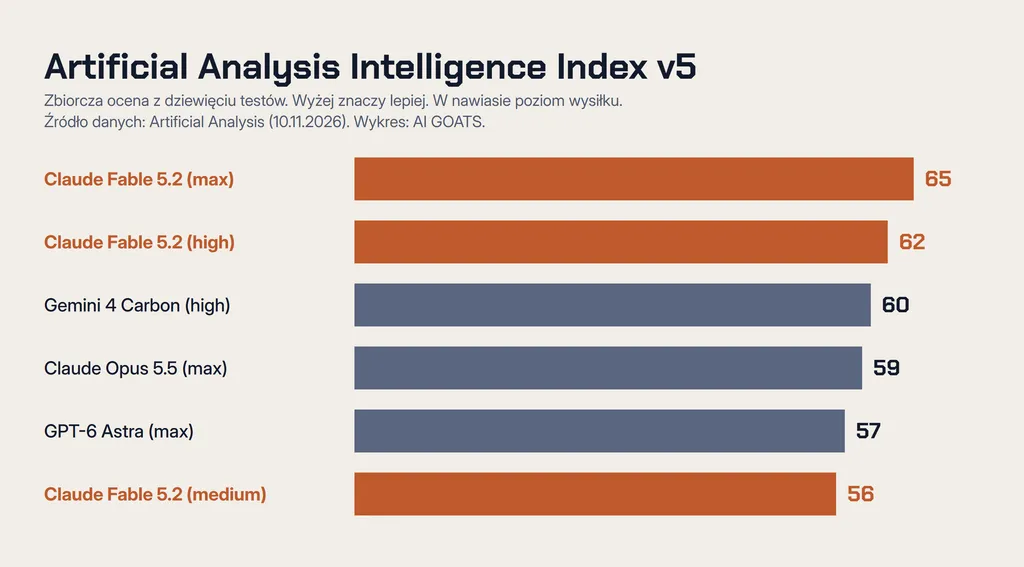
Poziom wysiłku mówi, jak długo model myśli przed odpowiedzią. Fable ma pięć takich poziomów: low, medium, high, xhigh i max. Już na poziomie high ma 62 punkty, czyli więcej niż Gemini 4 Carbon (60), Claude Opus 5.5 na maksimum (59) i GPT-6 Astra na maksimum (57). Według The Decoder Fable 5.1 miał w tym indeksie o 15 punktów mniej.
Według The Decoder Fable wygrywa pięć z dziewięciu składowych indeksu, w tym Terminal-Bench Science (73%) i FrontierCode 2.0 (49%). W Terminal-Bench 4.0, czyli pracy w terminalu, remisuje z Opusem 5.5 (60%), a Gemini 4 Carbon i Claude Sonnet 5.5 są wyżej. W AA-Briefcase, teście długich zadań biurowych, wyniki Fable, Opus 5.5 i Sonnet 5.5 mieszczą się w granicach błędu pomiaru.
Co pokazują oficjalne testy Anthropic?
Anthropic opublikował tabelę, w której zestawia Fable 5.2 z poprzednikiem i z rywalami. Wyniki są z najwyższego dostępnego poziomu wysiłku, o ile nie zaznaczono inaczej.
| Test | Co sprawdza | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|---|
| FrontierSWE v2 | trudne zadania programistyczne | 69,9% | 56,3% | 62,3% | 65,5% | 61,2% |
| OSWorld 2.1 | samodzielna obsługa komputera | 89,3% | 83,5% | 87,2% | 79,5% | 81,5% |
| Humanity’s Last Exam (z narzędziami) | pytania eksperckie z wielu dziedzin | 74,2% | 65,6% | 67,7% | 57,2% | brak |
| Terminal-Bench Science | zadania naukowe w terminalu | 74,6% | 52,6% | 58,7% | 68,1% | 64,8% |
| AutomationBench | automatyzacja pracy biurowej | 51,4% | 31,4% | 42,5% | 41,4% | 53,9% |
Tabelę układał producent, więc to on wybrał testy. Jeden wiersz oddaje rywalowi: w AutomationBench firmy Zapier lepszy jest Gemini 4 Carbon. Liczby zgadzają się z tymi, które przytacza The Decoder.
Dlaczego jedno zadanie na poziomie max kosztuje 26 dolarów?
Cena za token to tylko połowa rachunku. Druga połowa to liczba tokenów, które model zużyje, zanim skończy pracę. Fable na najwyższym poziomie myśli bardzo długo i przy okazji pisze dużo tekstu, którego użytkownik nie widzi.
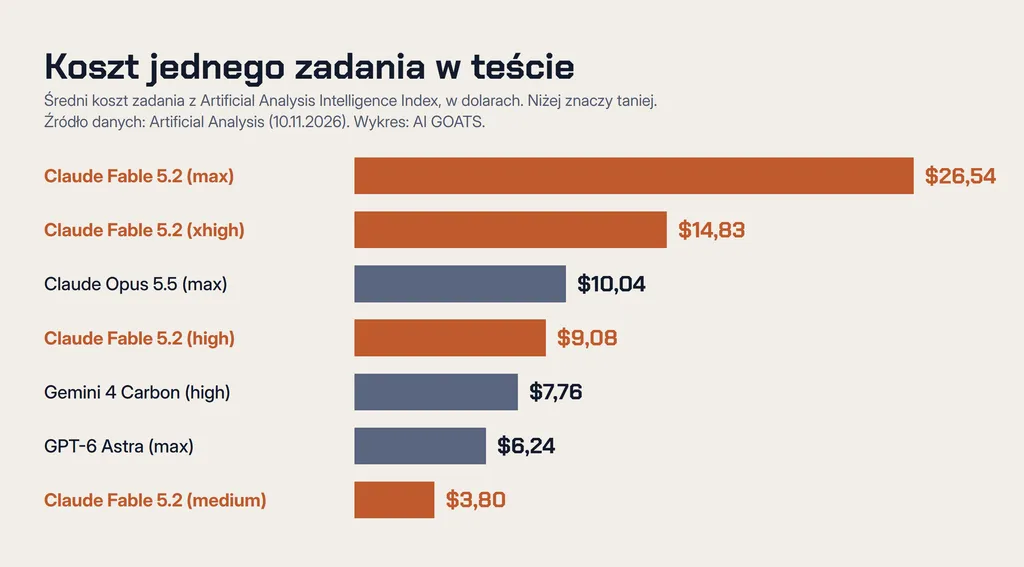
Według Artificial Analysis w całym teście Fable 5.2 na poziomie max wygenerował 275 milionów tokenów odpowiedzi. GPT-6 Astra potrzebował 54 milionów, czyli około pięć razy mniej. Dlatego jedno zadanie kosztowało Fable 26,54 dolara, Opus 5.5 na maksimum 10,04 dolara, a Astrę 6,24 dolara.
Fable nie jest przy tym wolny w pisaniu. Artificial Analysis zmierzył 103 tokeny na sekundę, a GPT-6 Astra 37. Długo trwa za to myślenie. Na poziomie max pierwsze słowo odpowiedzi pojawia się średnio po 235 sekundach, a jedno zadanie z testu zajmuje 44 minuty. To najwolniejszy wynik w rankingu.
Ta sama zależność wychodzi w testach twórców. Mervin Praison porównał na swoim kanale Fable 5.2 na poziomie high z Opus 5.5 na maksimum w trzech zadaniach. Fable zrobił wszystkie trzy za 0,73 dolara. Opus wydał 2,60 dolara i skończył jedno, bo w dwóch pozostałych przekroczył limit tokenów, zanim cokolwiek napisał.
Podobny wniosek wyciąga sam producent. W ogłoszeniu pisze, że w teście FrontierCode Fable 5.2 na poziomie high wypada mniej więcej jak najlepszy wynik Opus 5.5, za mniej więcej połowę kosztu zadania, i wyżej niż najlepszy wynik GPT-6 Astra przy podobnym koszcie.
Jak ustawić poziom wysiłku Fable 5.2 w Claude Code?
W aplikacjach Claude i w Claude Code Fable 5.2 domyślnie pracuje na poziomie medium. Anthropic pisze, że na tym poziomie robi trudne zadania mniejszą liczbą tokenów niż Fable 5.1. W Artificial Analysis poziom medium daje 56 punktów za 3,80 dolara za zadanie.
Poziom zmienia się w Claude Code komendą /effort, na przykład:
/effort highDostępne są wartości low, medium, high, xhigh i max. Według danych Artificial Analysis najlepiej wypada high: 62 punkty za 9,08 dolara. Xhigh daje ten sam wynik za 14,83 dolara, a max dodaje 3 punkty za prawie trzy razy wyższy rachunek. Mervin Praison i Nikita Jefimow, których filmy przejrzeliśmy, odradzają poziom max przy codziennej pracy.
Sam Anthropic radzi, żeby przy większości zadań z kodem i wiedzą zaczynać od Claude Opus 5.5, a po Fable sięgać przy najtrudniejszych, otwartych projektach. Jak pracować w Claude Code krok po kroku, pokazujemy w poradniku film z jednego promptu.
Czy Fable 5.2 jest dostępny w planie Claude Pro?
Tak, przez tydzień. Według centrum pomocy Claude plany Pro i standardowe miejsca w planie Team mają wszystkie modele Fable w abonamencie do 16 listopada (23:59 czasu pacyficznego). Fable może zużyć najwyżej 50% tygodniowego limitu. Potem w Pro wraca rozliczenie przez dodatkowe kredyty.
Płacący przed 9 listopada dostają też jeden reset Fable. Używa się go w Ustawieniach, w zakładce Użycie. Reset oddaje limit zużyty na Fable i odnawia limit pięciogodzinny, ale nie podnosi samych limitów. Plany Max i Ultra dostają od jednego do trzech resetów, zależnie od stażu, ważnych do 8 marca 2027 roku. Plan darmowy nie ma Fable.
Domyślny model się nie zmienia. Fable trzeba wybrać ręcznie na liście modeli, a według Anthropic zużywa on limity szybciej niż inne modele Claude. Jak wydłużyć limit w Claude, opisujemy w poradniku 4 sposoby na limity.
Najczęstsze pytania o Claude Fable 5.2 (FAQ)
Ile kosztuje Claude Fable 5.2?
Według Anthropic w API 8 dolarów za milion tokenów wysłanych do modelu i 40 dolarów za milion tokenów odpowiedzi. Tryb szybki kosztuje 16 i 80 dolarów. W planie Claude Pro Fable jest w abonamencie do 16 listopada 2026 roku, do połowy tygodniowego limitu.
Czy Fable 5.2 jest lepszy od Opus 5.5?
W rankingu Artificial Analysis tak: 65 punktów wobec 59, a na poziomie high 62 punkty. W testach Anthropic Fable wygrywa w programowaniu i obsłudze komputera. Kosztuje jednak dwa razy więcej za token, dlatego Anthropic radzi zaczynać codzienną pracę od Opus 5.5.
Czy Fable 5.2 jest lepszy od GPT-6 Astra?
W rankingu Artificial Analysis Fable ma 65 punktów, a GPT-6 Astra 57. Fable jest o 20% tańszy za token, ale na poziomie max jedno zadanie kosztuje u niego ponad cztery razy więcej, bo zużywa około pięć razy więcej tokenów.
Jaki poziom wysiłku wybrać w Claude Code?
Domyślny jest medium. Przy trudnych zadaniach dane Artificial Analysis wskazują high (komenda /effort high): 62 punkty za 9,08 dolara za zadanie. Poziom max kosztuje prawie trzy razy więcej i daje 3 punkty więcej.
Czym różni się Fable 5.2 od Mythos 5.2?
To ten sam model. Mythos 5.2 ma zdjętą część zabezpieczeń i jest dostępny tylko dla sprawdzonych organizacji z cyberbezpieczeństwa i nauk o życiu. Fable 5.2 jest dostępny dla wszystkich płacących użytkowników i w API.
Źródła
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2
- Claude Platform Docs: What’s new in Claude Fable 5.2
- Claude Platform Docs: Pricing
- Claude Help Center: Claude Fable 5.2 launch offers
- OpenAI: API Pricing
- Artificial Analysis: Claude Fable 5.2
- Artificial Analysis: Claude Fable 5.2 (high)
- Artificial Analysis: Claude Opus 5.5
- Artificial Analysis: GPT-6 Astra
- Artificial Analysis: ranking modeli
- The Decoder: Claude Fable 5.2 and Mythos 5.2 cement Anthropic’s AI lead
- Mervin Praison: Claude Fable 5.2 vs Opus 5.5: What It REALLY Costs