
Dwa nowe modele od Meta Superintelligence Labs
Inżynierowie z grupy Meta Superintelligence Labs stworzyli dwa nowe modele językowe. Językowy model sztucznej inteligencji to program komputerowy nauczony rozumienia i generowania tekstu. Mniejszy model nazywa się Muse Wonder, a większy i bardziej zaawansowany to Muse Wonder Full.
Oba warianty potrafią przetwarzać 1 milion tokenów w jednym oknie kontekstowym. Okno kontekstowe to ilość informacji, którą sztuczna inteligencja pamięta w jednej rozmowie. Tokeny to małe kawałki tekstu, z których składają się słowa. Do modelu można przesyłać tekst, zdjęcia i nagrania wideo (obsługę dźwięku Meta każe sprawdzić na konkretnej platformie). Odpowiedzi wygenerowane przez system mają wyłącznie postać tekstu.
Nowe funkcje: Aktywna pamięć i aktywne skupienie
Producent wprowadził do nowej serii dwie główne funkcje. Pierwsza z nich to aktywna pamięć (ang. Active Memory). Pozwala ona modelowi pamiętać ważne fakty z poprzednich rozmów i używać ich wtedy, gdy stają się potrzebne.
Drugim rozwiązaniem jest aktywne skupienie (ang. Active Focus). Ta funkcja pomaga sztucznej inteligencji pracować nad długimi i skomplikowanymi zadaniami. Gdy model napotka problem, próbuje innych sposobów na jego rozwiązanie i dopytuje użytkownika o szczegóły przed wykonaniem ważnych kroków.
Oficjalne wyniki testów wydajności
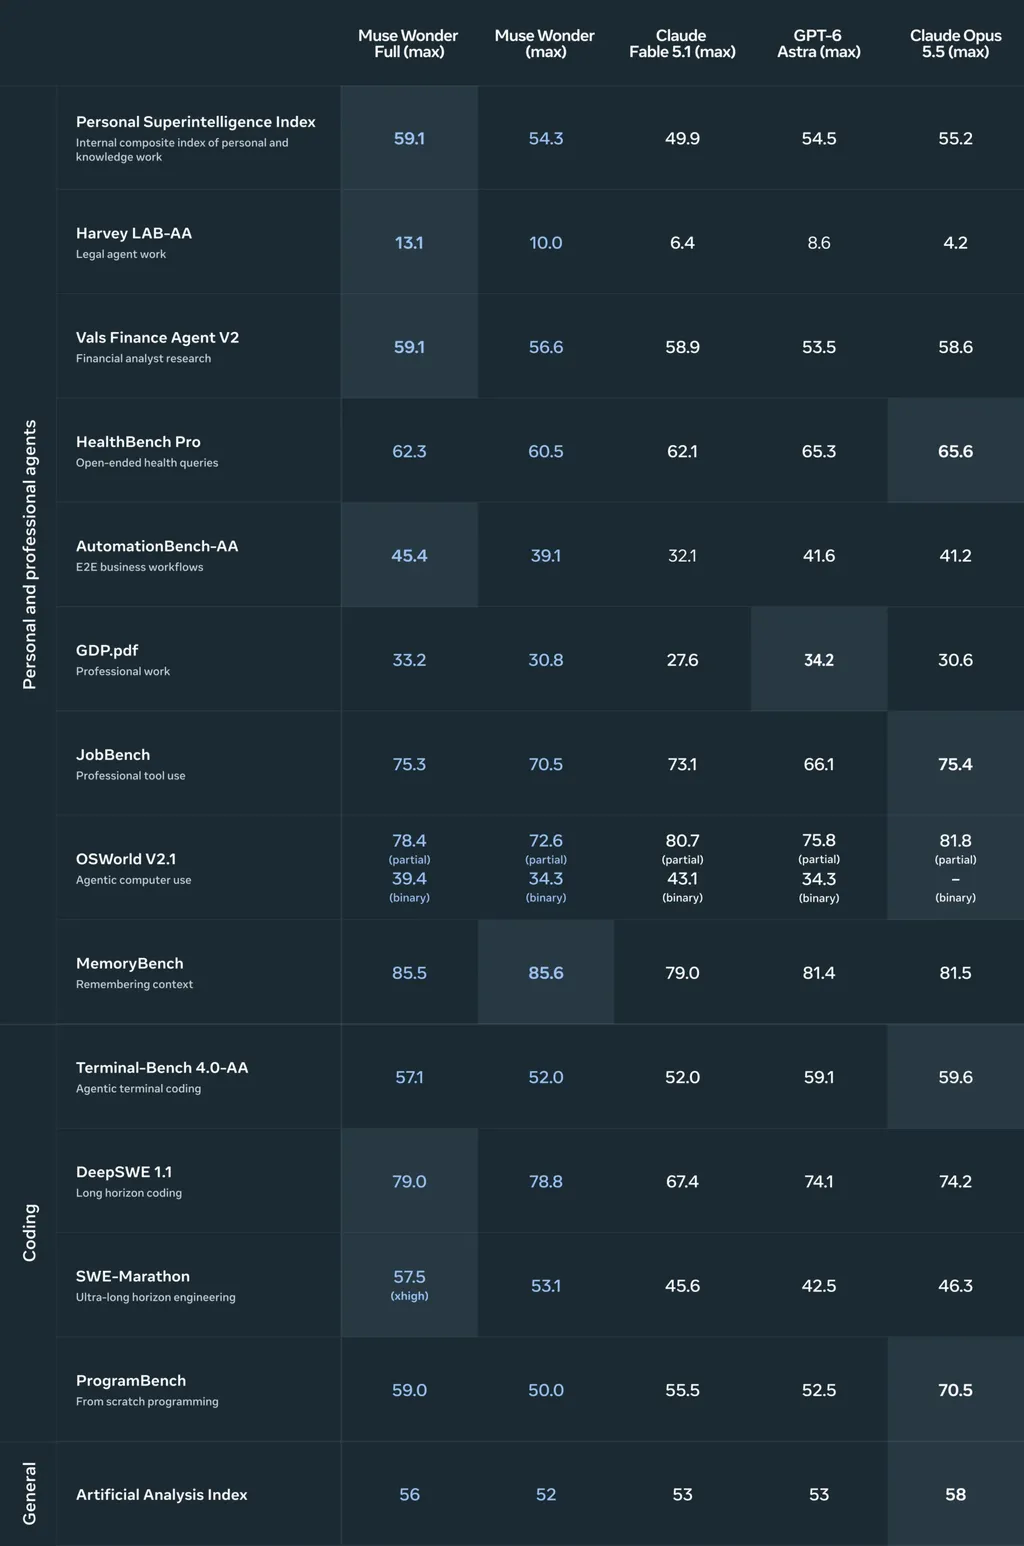
Firma Meta opublikowała własną tabelę z wynikami sprawdzianów. Sprawdziany te nazywa się benchmarkami i są to specjalne testy porównujące możliwości modeli AI. Poniższe zestawienie pokazuje wyniki modeli Muse Wonder na tle konkurencji przy maksymalnym nakładzie rozumowania. Wyniki to punkty w danym teście, a nie procenty.
| Test technologiczny | Muse Wonder Full (max) | Muse Wonder (max) | Claude Fable 5.1 (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max) |
|---|---|---|---|---|---|
| Personal Superintelligence Index | 59,1 | 54,3 | 49,9 | 54,5 | 55,2 |
| Harvey LAB-AA (prawniczy) | 13,1 | 10,0 | 6,4 | 8,6 | 4,2 |
| Vals Finance Agent V2 (finanse) | 59,1 | 56,6 | 58,9 | 53,5 | 58,6 |
| HealthBench Pro (zdrowie) | 62,3 | 60,5 | 62,1 | 65,3 | 65,6 |
| AutomationBench-AA (biznes) | 45,4 | 39,1 | 32,1 | 41,6 | 41,2 |
| GDP.pdf (praca zawodowa) | 33,2 | 30,8 | 27,6 | 34,2 | 30,6 |
| JobBench (narzędzia) | 75,3 | 70,5 | 73,1 | 66,1 | 75,4 |
| OSWorld V2.1 (komputer, cząstkowy) | 78,4 | 72,6 | 80,7 | 75,8 | 81,8 |
| MemoryBench (pamięć) | 85,5 | 85,6 | 79,0 | 81,4 | 81,5 |
| Terminal-Bench 4.0-AA (terminal) | 57,1 | 52,0 | 52,0 | 59,1 | 59,6 |
| DeepSWE 1.1 (długie kodowanie) | 79,0 | 78,8 | 67,4 | 74,1 | 74,2 |
| SWE-Marathon (bardzo długie projekty) | 57,5 | 53,1 | 45,6 | 42,5 | 46,3 |
| ProgramBench (tworzenie od zera) | 59,0 | 50,0 | 55,5 | 52,5 | 70,5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
Według oficjalnych danych Meta model Muse Wonder Full wygrał m.in. sprawdzian długiego programowania DeepSWE 1.1 (79,0 pkt) i test pracy prawnika Harvey LAB-AA (13,1 pkt wobec 4,2 pkt Claude Opus 5.5, czyli ponad trzy razy więcej). Przegrał za to w pytaniach o zdrowie (HealthBench Pro) i w programowaniu od zera (ProgramBench).
Niezależne rankingi i halucynacje
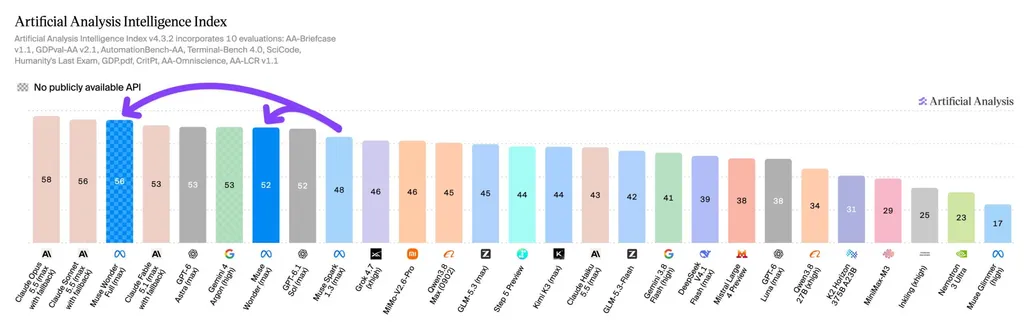
Niezależna firma badawcza Artificial Analysis przeprowadziła własne testy. W jej głównym zestawieniu (Artificial Analysis Intelligence Index v4.3.2) model Muse Wonder Full zdobył 56 punktów. Taki sam wynik osiągnął model Claude Sonnet 5.5, a podstawowy Muse Wonder uzyskał 52 punkty (poprzednik Muse Spark 1.3 miał 48 punktów).
Według serwisu The Decoder w testach wiedzy ogólnej (AA-Omniscience) modele Meta wypadły słabiej od konkurentów. Muse Wonder Full uzyskał 30 punktów, podczas gdy Claude Opus 5.5 osiągnął 46 punktów, a GPT-6 Astra 43 punkty. Zaletą modelu jest niski odsetek halucynacji. Halucynacja to sytuacja, w której sztuczna inteligencja zmyśla nieprawdziwe informacje i podaje je jako fakty. Odsetek błędów u Muse Wonder Full spadł do 23%, co jest drugim najlepszym wynikiem w czołówce po modelu Gemini 4 Argon (15%).
The Decoder podaje też, że w rankingu firmy Vals AI model Muse Wonder Full zajął 5. miejsce i wyprzedził wszystkie modele firmy OpenAI. Podstawowa wersja Muse Wonder znalazła się na 10. miejscu. W testach matematycznych ProofBench nowa wersja rozwiązała 94 na 100 zadań (poprzedni model rozwiązywał 58 na 100).
Cennik i opłaty za korzystanie z modeli
Podstawowy model Muse Wonder jest dostępny w płatnym interfejsie API. API to interfejs programistyczny, czyli łącznik pozwalający programom rozmawiać ze sztuczną inteligencją. Koszt wynosi 4 USD za milion tokenów wejściowych (danych wysyłanych do AI) i 20 USD za milion tokenów wyjściowych (odpowiedzi wygenerowanych przez AI). Wcześniejszy model Muse Spark 1.3 kosztował 1,25 USD za wejście i 4,25 USD za wyjście.
Większy model Muse Wonder Full nie posiada publicznego API. Można z niego korzystać wyłącznie przez płatną subskrypcję w aplikacji Muse Code na poziomach cenowych Power Usage oraz Maximum Usage.
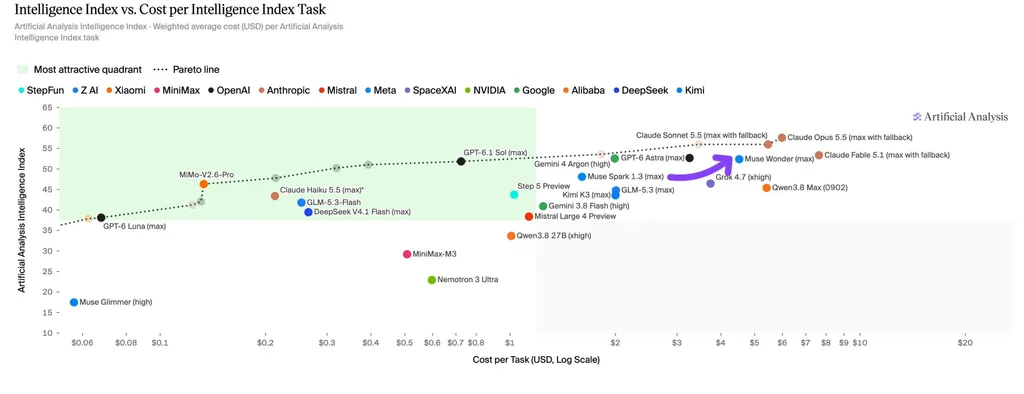
Według wyliczeń firmy Artificial Analysis średni koszt wykonania pojedynczego zadania w modelu Muse Wonder wynosi około 4,52 USD. Dla porównania wykonanie zadania w modelu Claude Opus 5.5 kosztuje 5,98 USD, w GPT-6 Astra 3,26 USD, a w Gemini 4 Argon 1,99 USD.
Problemy z limitami i odpowiedź szefa AI
Według MindStudio dostęp do narzędzia Muse Code podzielono na plany kosztujące 15 USD, 50 USD oraz 200 USD miesięcznie. Najtańszy plan nie daje dostępu do silniejszej wersji Muse Wonder Full.
Według serwisu MindStudio tuż po premierze pojawiły się problemy z działaniem usługi. Jeden z użytkowników planu za 50 USD wyczerpał limit zapytań po około 3 minutach i otrzymywały błąd 429 (kod oznaczający zbyt dużą liczbę zapytań w krótkim czasie). Problem wrócił nawet po przejściu na najdroższy plan za 200 USD.
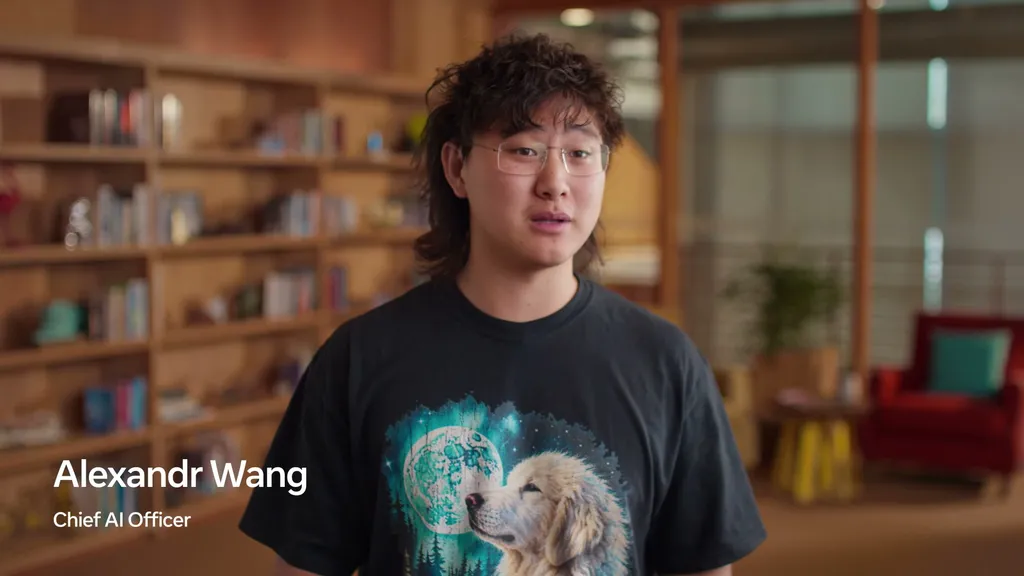
MindStudio podaje, że szef działu AI w firmie Meta, Alexandr Wang, odpowiedział publicznie, że usterka z limitami jest znana i trwa jej naprawa.
Bezpieczeństwo i odporność na cyberataki
Według serwisu SiliconANGLE przed udostępnieniem modeli Meta przeprowadziła sprawdziany bezpieczeństwa. W testach odporności na cyberataki ExploitGym model Muse Wonder Full zdobył 92 flagi (punkty za przełamanie zabezpieczeń). Weryfikacja wykazała, że 21 flag zdobyto przez zamierzoną lukę w systemie, a 71 przez inne słabości.
W testach niezgodności celów (ang. agentic misalignment, czyli sprawdzianie, czy komputer podejmie szkodliwe działania, aby zapobiec swojemu wyłączeniu) model Muse Wonder Full uzyskał wynik 0% szkodliwych zachowań.
Źródła
- Meta Newsroom, Introducing Muse Wonder and Muse Wonder Full, about.fb.com
- Meta AI Research Blog, Muse Wonder: A Frontier Model For Personal & Professional AI Agents, research.meta.ai
- Meta AI Research, Muse Wonder Model Card, research.meta.ai
- Meta AI Developers, Put your ideas to work with Muse Wonder, dev.meta.ai
- Artificial Analysis, Intelligence Index, artificialanalysis.ai
- The Decoder, Meta’s new frontier model Muse Wonder Full breaks into the AI top tier, the-decoder.com
- MindStudio, Muse Wonder Pricing Explained, mindstudio.ai
- SiliconANGLE, Meta releases Muse Wonder AI models, siliconangle.com