
Premiera w wersji testowej
Publiczna wersja testowa Mistral Large 4 jest dostępna od 6 października. W ogłoszeniu firma żartuje, że nieoficjalnie model nazywa się ML4, a „bardzo oficjalnie” Le Chonk. Na razie można go używać tylko przez API w usłudze Mistral Studio. API to łącze, przez które programiści podłączają model do własnych aplikacji.
Mistral zapowiedział, że otwarte wagi opublikuje do końca października. Wagi to pliki z „wiedzą” modelu. Kto je ma, może uruchomić model na własnych serwerach. Według serwisu Airtics strona modelu na Hugging Face pokazuje datę 31 października 2026. Warunki licencji nie zostały jeszcze ogłoszone.
Bilion parametrów i mieszanka ekspertów
Według Mistrala model ma 1 bilion parametrów, z czego przy każdym kroku pracuje 52 miliardy. Parametry to liczby, które model ustawia podczas nauki. Serwis MarkTechPost podaje dokładniejsze wartości: 1,05 biliona parametrów i 49 miliardów aktywnych.
Taka budowa nazywa się mieszanką ekspertów (mixture of experts). Model działa jak duża firma z wieloma specjalistami. Przy każdym słowie do pracy zostaje wezwanych tylko kilku z nich, a reszta czeka. Dzięki temu model jest ogromny, ale każde słowo kosztuje mniej obliczeń.
Mistral Large 4 rozumie tekst i obrazy, a odpowiada tekstem. Według Artificial Analysis w jednym zapytaniu można teraz wysłać 100 obrazów. Wcześniejsze modele Mistrala przyjmowały najwyżej 8.
Okno kontekstu to ilość tekstu, którą model może przeczytać naraz. Artificial Analysis podaje 512 tysięcy tokenów, czyli kawałków tekstu. Część mediów pisze o milionie tokenów. Sam Mistral nie podał tej liczby w ogłoszeniu.
Wytrenowany w Europie
Mistral podaje, że wytrenował model od zera na 3800 kartach NVIDIA Grace Blackwell we własnych centrach danych w Europie. Na tym samym sprzęcie działa teraz wersja testowa. Duża część danych treningowych była wielojęzyczna. Model zna ponad 160 języków, w tym wszystkie języki urzędowe Unii Europejskiej.
Model ma być dostępny w wielu regionach świata. Jedna z wersji będzie działać w Europie, w całości obsługiwana przez Mistrala i podlegająca europejskiemu prawu. Dla firm, które nie chcą wysyłać danych poza Unię, to ważna informacja.
Wynik w rankingu Artificial Analysis
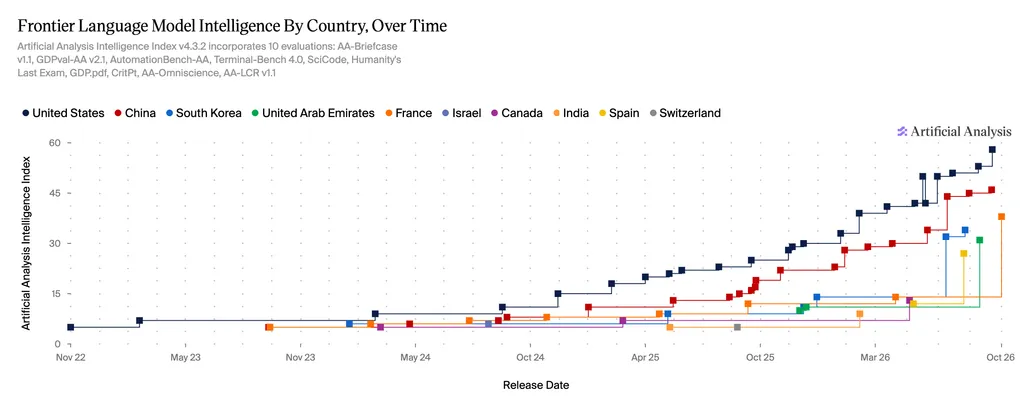
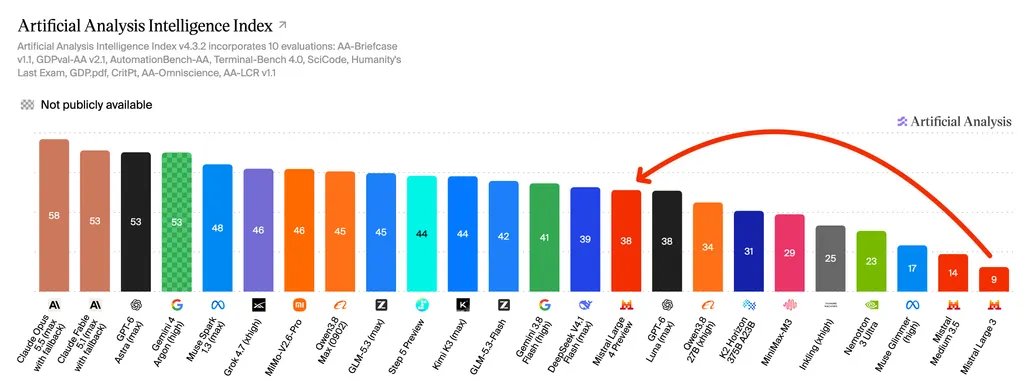
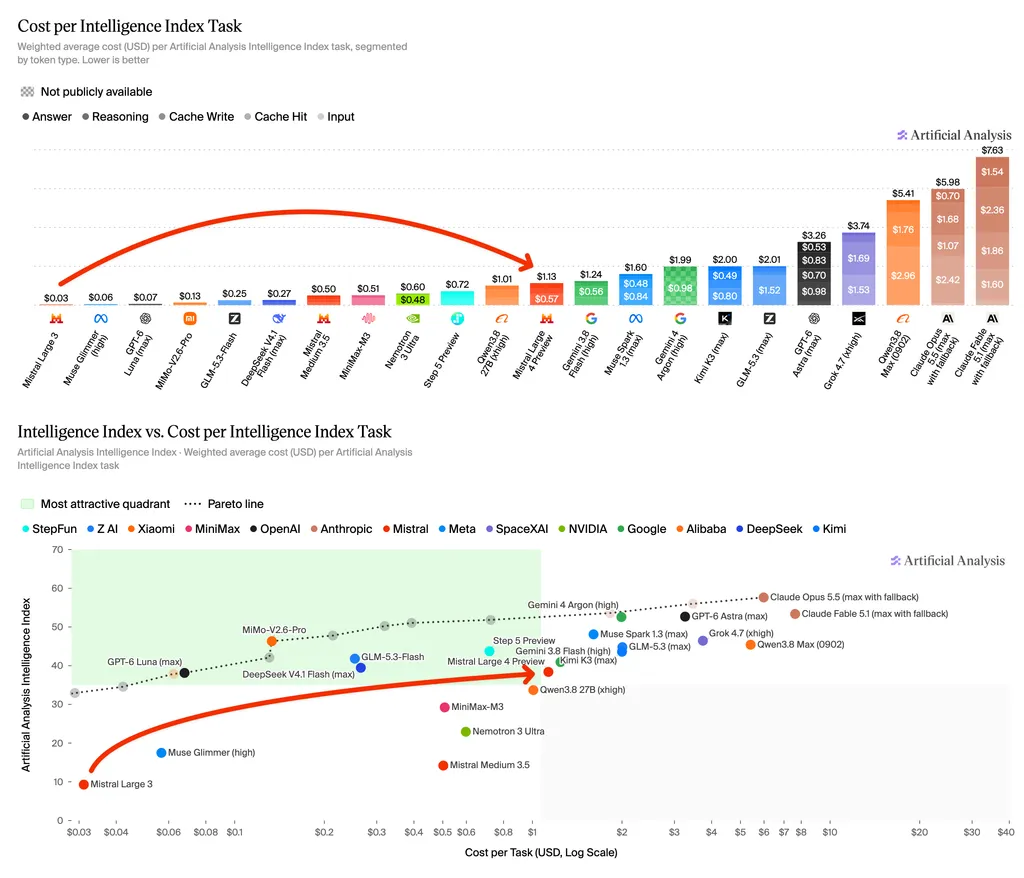
Niezależna firma badawcza Artificial Analysis przyznała modelowi 38 punktów w swoim indeksie inteligencji. Na stronie modelu oznacza to 65. miejsce na 216 modeli. Artificial Analysis podkreśla, że to najlepszy model stworzony poza USA i Chinami.
Wynik jest podobny do modeli DeepSeek V4.1 Flash (39 punktów) i GPT-6 Luna (38 punktów). Wyżej są chińskie modele z otwartymi wagami: Kimi K3 (44), GLM-5.3 (45) i MiMo-V2.6-Pro (46). W ogólnym rankingu Mistral Large 4 jest więc w środku stawki.
Cyberbezpieczeństwo: najlepszy wynik i słabsze testy
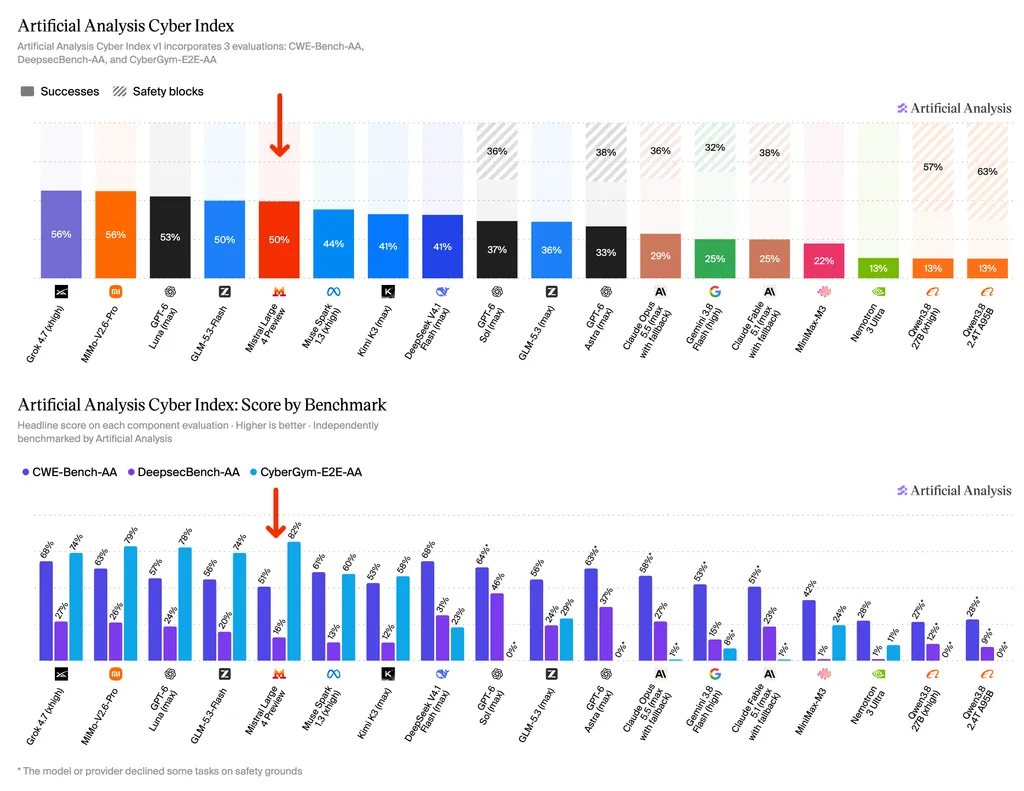
Mistral szczególnie chwali się cyberbezpieczeństwem. W indeksie cyberbezpieczeństwa Artificial Analysis model ma 50 punktów. Najlepiej wypadł w teście CyberGym-E2E-AA, w którym rozwiązał 82% zadań. To najlepszy wynik w tym teście, przed MiMo-V2.6-Pro (79%) i GPT-6 Luna (78%).
W innych częściach tego indeksu poszło mu gorzej. Serwis Tom’s Hardware zwraca uwagę na 16% w DeepsecBench-AA i 51% w CWE-Bench-AA.
Mistral tłumaczy, dlaczego cyberbezpieczeństwo jest dla niego ważne. Zamknięte modele często odmawiają pomocy przy szukaniu luk w zabezpieczeniach, nawet gdy robi to uprawniony specjalista. Otwarte wagi pozwalają uruchomić model we własnej firmie, według własnych zasad.
Firma podaje też wyniki z własnych pomiarów: 93% w teście cyberbezpieczeństwa Cybench, 61,7% w teście programowania DeepSWE i ok. 27–28% w Terminal-Bench 4.0. W ślepym teście programowania firmy Surge AI, zleconym przez Mistrala, model dostał 3,74 na 5 punktów. To 2. miejsce na 5 modeli, za Claude Opus 5 (4,22). Te liczby pochodzą od producenta.
Cena za token i realny koszt zadania
Mistral ustalił cenę 1,36 USD za milion tokenów wysłanych do modelu i 4,18 USD za milion tokenów odpowiedzi. Tokeny zapamiętane w pamięci podręcznej kosztują 0,14 USD za milion. Według Artificial Analysis to mniej niż mediana rynku, która wynosi 2 USD i 10 USD. Przez pierwsze dwa tygodnie obowiązuje zniżka 50% (0,68 USD i 2,09 USD).
Artificial Analysis zauważyło jednak, że model pisze bardzo długie odpowiedzi. W jego testach Mistral Large 4 wygenerował 200 milionów tokenów, podczas gdy mediana wynosi 85 milionów. Dłuższa odpowiedź to wyższy rachunek.
Dlatego jedno zadanie z indeksu kosztuje średnio 1,13 USD, a w promocji 0,57 USD. To ponad 4 razy więcej niż w podobnie inteligentnych modelach GLM-5.3-Flash (0,25 USD) i DeepSeek V4.1 Flash (0,27 USD).
Otwarte wagi, sprzęt i krytyka
Po publikacji wag każdy będzie mógł pobrać model. Uruchomienie go nie będzie jednak łatwe. Według szacunków serwisów MarkTechPost i Yotta Labs potrzeba od 0,5 do 1 TB pamięci kart graficznych, czyli serwerów z co najmniej 8 kartami klasy NVIDIA B200 lub H200. To sprzęt dla dużych firm i instytucji, a nie dla zwykłego komputera.
Analitycy zwracają uwagę na trzy słabe strony. Model jest przedstawiany jako otwarty, a w dniu premiery wag nie było. W ogólnym rankingu zajmuje środkowe miejsca. Przez długie odpowiedzi jedno zadanie kosztuje więcej, niż sugeruje cennik. TrueFoundry opisuje wynik 38 punktów jako środek stawki, daleko za najlepszymi zamkniętymi modelami.
Źródła
- Mistral AI, Introducing Mistral Large 4, mistral.ai
- Artificial Analysis, Mistral has released Mistral Large 4, making France home to the most intelligent model outside the US and China, artificialanalysis.ai
- Artificial Analysis, Mistral Large 4 Preview — Intelligence, Performance & Price Analysis, artificialanalysis.ai
- Tom’s Hardware, Independent tests rank Mistral’s new trillion-parameter Large 4 the best AI model outside the U.S. and China, tomshardware.com
- MarkTechPost, Mistral AI Releases Mistral Large 4 (Le Chonk), marktechpost.com
- Yotta Labs, Mistral Large 4 hardware requirements, yottalabs.ai
- TrueFoundry, Mistral Large 4 Review: Pricing, Benchmarks and Real Cost, truefoundry.com
- Airtics Education, Mistral Large 4 Explained Simply: Open Weights, airtics.org